




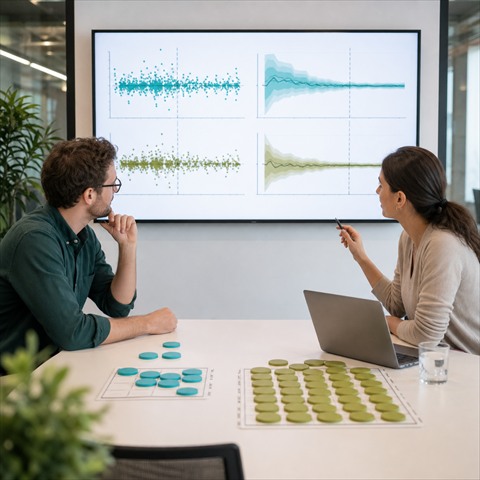
Esta é uma das perguntas mais frequentes entre equipes que estão começando a usar testes A/B: quantos visitantes, ou quantas conversões, são necessários para que os resultados de um teste sejam confiáveis? A resposta não é um número único e universal — depende da sua taxa de conversão inicial, da magnitude da mudança que você está tentando detectar e do nível de certeza que você precisa antes de tirar uma conclusão. Este artigo explica esses fatores um a um, sem fórmulas matemáticas complexas, para que você possa estimar o tamanho da amostra necessário para um teste confiável.
Por que o tamanho da amostra é a questão mais importante em um teste?
Um teste A/B compara o comportamento de dois grupos de visitantes expostos a duas versões diferentes de uma página. Mas o comportamento humano varia naturalmente de um visitante para outro, independentemente da versão visualizada: em alguns dias, em alguns momentos, alguns perfis convertem melhor do que outros por razões não relacionadas ao teste realizado. Com uma amostra pequena, essa variação natural — o "ruído" estatístico — pode facilmente produzir uma diferença entre os dois grupos que se assemelha a um efeito real, quando na verdade é apenas uma flutuação aleatória.
O tamanho da amostra é o principal fator para distinguir um sinal verdadeiro do ruído. Quanto maior a amostra, mais as flutuações aleatórias tendem a se cancelar mutuamente e maior a probabilidade de uma diferença medida entre dois grupos refletir um efeito real da mudança testada, em vez de uma coincidência. Realizar um teste sem estimar o tamanho da amostra necessário equivale a decidir antecipadamente se o resultado obtido será confiável.
A taxa de conversão inicial
O primeiro fator a ser considerado é a taxa de conversão atual da página ou jornada do usuário que está sendo testada, com base na métrica que será usada para avaliar o teste. Esse valor pode ser facilmente obtido a partir dos dados já disponíveis em sua ferramenta de análise: número de conversões dividido pelo número de visitantes, em um período recente e representativo (excluindo, se possível, períodos com promoções excepcionais ou picos de tráfego atípicos).
Essa taxa inicial influencia diretamente o tamanho da amostra necessário: para o mesmo efeito, uma taxa de conversão baixa (por exemplo, 1%) requer uma amostra maior do que uma taxa de conversão alta (por exemplo, 20%) para detectar a mesma diferença relativa. Essa é uma das razões pelas quais testes com métricas pouco frequentes (uma compra, uma assinatura) geralmente exigem mais tráfego e tempo do que testes com métricas mais frequentes (um clique, uma rolagem de página).
O MDE, ou a magnitude do efeito que estamos tentando detectar.
O MDE (Efeito Mínimo Detectável) refere-se à menor diferença entre o controle e a variante que o teste consegue detectar de forma confiável. É uma escolha, não um valor medido: você decide qual nível de melhoria vale a pena detectar.
Essa escolha tem um impacto drástico no tamanho da amostra necessário. Detectar um pequeno efeito (por exemplo, aumentar a taxa de conversão de 5% para 5,2%, uma melhoria relativa de 4%) exige um tráfego significativamente maior do que detectar um grande efeito (aumentar a mesma taxa de 5% para 6,5%, uma melhoria relativa de 30%). Na prática, isso significa que uma pequena alteração — a cor de um botão, uma palavra no título — exige um tamanho de amostra consideravelmente maior do que uma reformulação completa da página, com o mesmo nível de tráfego, simplesmente porque se espera um efeito mais modesto.
A consequência prática é simples: em um site com tráfego moderado, é melhor concentrar os primeiros testes em mudanças que produzam um efeito claro (reestruturação de uma página, simplificação de um percurso) em vez de microajustes que levariam meses para produzir um resultado utilizável.
O nível de confiança e o poder estatístico.
Outros dois parâmetros, de natureza mais técnica, completam o cálculo. O nível de confiança (geralmente definido em 95%) indica a probabilidade de declarar erroneamente um teste como vencedor quando, na verdade, não há diferença entre as duas versões — o que se chama de falso positivo. O poder estatístico (geralmente definido em 80%) indica a probabilidade de detectar um efeito real, caso ele exista, em vez de concluir erroneamente que não há diferença — um falso negativo.
Esses dois valores (95% e 80%) são convenções amplamente utilizadas na indústria de testes A/B, não regras absolutas. Aumentá-los (por exemplo, visando 99% de confiança) reduz o risco de uma conclusão incorreta, mas aumenta ainda mais o tamanho da amostra necessário; reduzi-los acelera a obtenção de um resultado, ao custo de um risco maior de se chegar a uma conclusão incorreta. Para um teste com consequências limitadas (um ajuste facilmente reversível), limites mais flexíveis podem ser justificados; para um teste cujo resultado determinará uma decisão custosa de implementar, limites mais rígidos são preferíveis.
Como estimar o tamanho da sua amostra na prática
Na prática, raramente é necessário calcular a fórmula estatística subjacente manualmente. A maioria das plataformas de teste A/B, incluindo o BlastOptimize, oferece uma calculadora que simplesmente solicita a taxa de conversão atual e o efeito mínimo que você deseja detectar, retornando diretamente o tamanho da amostra necessário por variante, bem como uma estimativa da duração do teste com base no tráfego atual da página.
Essa estimativa deve ser feita antes do início do teste, nunca depois. Ela serve para decidir se o teste é viável dentro de um prazo razoável, considerando o tráfego disponível, e, caso contrário, ajustar o escopo da mudança que está sendo testada (buscando um efeito mais amplo e, portanto, um MDE maior), ou o escopo do teste (agrupando várias páginas com baixo tráfego em vez de testar uma página isolada), ou ainda considerar outros métodos de pesquisa (testes qualitativos com usuários, pesquisas) quando o tráfego simplesmente não permite alcançar uma amostra suficiente dentro de um prazo razoável.
O erro de "espiar": olhar para o resultado antes do fim.
Uma vez estimado o tamanho da amostra, a disciplina mais importante é esperar até que ele seja atingido antes de tirar uma conclusão — mesmo que o painel mostre uma discrepância impressionante após apenas alguns dias. Esse comportamento, conhecido como "espiar", é uma das causas mais frequentes de resultados falsos em testes A/B: os indicadores de significância estatística exibidos em tempo real pela maioria das ferramentas são calculados continuamente, e uma discrepância pode parecer significativa em um determinado momento e depois diminuir, ou até mesmo se inverter, quando o tamanho total da amostra for atingido.
A regra prática mais simples para evitar essa armadilha é definir, antes de iniciar o teste, um tamanho mínimo de amostra e uma duração mínima (geralmente de pelo menos uma a duas semanas, para abranger as variações entre dias úteis e fins de semana), e considerar o resultado como definitivo somente quando ambas as condições forem atendidas simultaneamente.
O que fazer quando o tráfego está muito baixo para um teste padrão
Nem todos os sites têm o tráfego necessário para testar micro-otimizações com uma amostra representativa ao longo de alguns dias. Quando o tráfego é limitado, alguns ajustes podem ajudar a continuar a melhorar:
- Testando mudanças com alto impacto esperado Em vez de microajustes, para reduzir o tamanho da amostra necessário.
- Agrupe as métricas Ao seguir um objetivo mais acima no funil (por exemplo, clique para adicionar ao carrinho em vez de compra final), quando este ainda for relevante para a hipótese que está sendo testada, uma vez que eventos mais frequentes exigem uma amostra menor.
- Prolongue a duração do teste. além das habituais duas semanas, aceitando um atraso maior antes da decisão.
- Complemente os testes A/B com métodos qualitativos. (testes de usuários, gravações de sessões, entrevistas com clientes) que não exigem um grande volume de tráfego para produzir insights acionáveis.
Um exemplo concreto para visualizar o raciocínio.
Para tornar esses conceitos mais concretos, vamos usar um exemplo puramente ilustrativo. Imagine uma landing page com uma taxa de conversão atual de 3% e uma equipe que deseja detectar um efeito relativo mínimo de 15% (ou seja, uma mudança de 3% para aproximadamente 3,45%), usando os limiares usuais de 95% de confiança e 80% de poder estatístico. Uma calculadora de tamanho de amostra indicaria, nesse cenário, que vários milhares de visitantes por variação são necessários para que o teste seja confiável — a ordem de grandeza exata depende da fórmula usada, mas o princípio permanece o mesmo: quanto menor for o efeito desejado em relação à taxa inicial, mais rápido o tamanho da amostra necessário aumenta.
Se a mesma página recebe apenas algumas centenas de visitantes por semana, este teste levaria vários meses para atingir o tamanho de amostra necessário — um prazo raramente compatível com o ritmo de uma equipe de marketing. Duas opções se apresentam então: revisar a hipótese para buscar um efeito mais amplo (uma mudança mais estrutural em vez de um pequeno ajuste) ou aceitar um MDE (Efeito Médio Diário) maior, o que reduz a sensibilidade do teste, mas também sua duração. Esse tipo de compensação, feita conscientemente antes do lançamento, é melhor do que um teste lançado sem consideração cuidadosa e interrompido prematuramente por impaciência.
Perguntas frequentes
A mesma amostra deve ser usada para o controle e para a variante?
Na grande maioria dos casos, sim: uma divisão igualitária do tráfego entre as duas versões é a configuração mais eficiente para atingir significância estatística o mais rápido possível, com tráfego total igual.
Podemos testar mais de duas variantes ao mesmo tempo?
Sim, mas cada variante adicional dilui o tráfego disponível por filial e aumenta o tempo necessário para obter uma amostra de tamanho suficiente para cada uma. Um teste A/B/C/D, com o mesmo tráfego total, requer significativamente mais tempo do que um teste A/B tradicional para chegar a uma conclusão confiável sobre cada variante.
É possível realizar um teste confiável em um site pequeno?
Sim, desde que as expectativas sejam ajustadas: priorize mudanças com alto potencial de impacto, aceite durações de teste mais longas e não hesite em complementar os testes A/B com métodos que não dependam do volume de tráfego, como testes qualitativos com usuários.
Principais conclusões
O tamanho da amostra não é um detalhe técnico reservado apenas para estatísticos; é o parâmetro que determina se um teste A/B produzirá uma conclusão confiável ou um resultado enganoso. Depende da taxa de conversão inicial, da magnitude do efeito que se pretende detectar e do nível de confiança necessário — três elementos que são melhor estimados antes do lançamento de um teste do que descobertos posteriormente, invalidando a conclusão. A boa notícia é que uma calculadora de tamanho de amostra integrada à ferramenta de teste é suficiente, na grande maioria dos casos, para realizar esse cálculo para a equipe de marketing.
O BlastOptimize integra essa calculadora diretamente em seu painel, fornecendo uma estimativa da duração necessária do teste com base no tráfego real da página testada, evitando assim a execução de um teste inconclusivo. Se você não tiver certeza sobre o tamanho da amostra necessário para o seu próximo teste, este é um bom ponto de partida para decidir antes mesmo de criar sua variante.
Publicações semelhantes:
- CRO: Definição, cálculo e um guia para iniciantes (2026)
- Call to action que converte: como redigi-la e…
- Significado estatístico de um teste A/B: o guia completo
- Kameleoon versus soluções sem código: o CRO…
- Testes A/B no comércio eletrônico: 7 ideias de alto impacto (2026)
- Como realizar seu primeiro teste A/B




Os comentários estão desativados.