




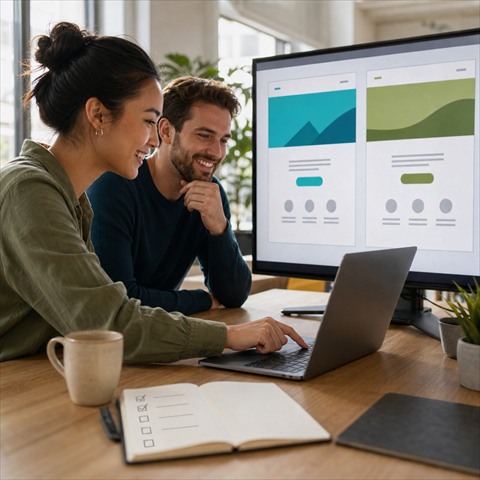
Lancer son premier test A/B peut sembler intimidant : entre le choix de l’outil, la peur de « casser » quelque chose sur le site en production, et l’incertitude sur la façon d’interpréter les résultats, beaucoup d’équipes marketing repoussent le moment de s’y mettre. Pourtant, la mécanique d’un test A/B bien mené repose sur un nombre restreint d’étapes, toutes accessibles sans compétence technique poussée. Ce guide décrit, étape par étape, comment structurer et lancer un premier test A/B qui produit un résultat exploitable, plutôt qu’un chiffre difficile à interpréter.
Pourquoi tester avant de généraliser un changement
L’intuition d’un designer ou d’un marketeur est une excellente source d’idées, mais une mauvaise base de décision à elle seule. Un bouton plus visible, un titre reformulé ou un formulaire raccourci peuvent sembler être des améliorations évidentes sur le papier, et pourtant faire baisser le taux de conversion une fois déployés — parce que le contexte réel des visiteurs (appareil, intention, historique avec la marque) échappe souvent à l’intuition. Le test A/B remplace le pari par la mesure : une partie du trafic voit la version actuelle (le contrôle), une autre voit la variante, et la différence de comportement entre les deux groupes donne une réponse fondée sur des données plutôt que sur une opinion.
Cette logique a un coût : un test prend du temps, nécessite du trafic, et n’apporte de réponse fiable que si quelques règles de méthode sont respectées. Les sept étapes qui suivent couvrent l’essentiel de ce qu’il faut savoir pour éviter les pièges les plus courants dès le premier test.
Étape 1 : partir d’une hypothèse claire, pas d’une idée vague
« Tester un nouveau bouton » n’est pas une hypothèse, c’est une intention. Une hypothèse de test relie une observation, un changement et un résultat attendu, sous une forme qui peut être validée ou invalidée sans ambiguïté. Une formulation utile ressemble à :
« Parce que [observation ou donnée], nous pensons que [changement] va provoquer [effet attendu], mesuré par [métrique]. »
Par exemple : « Parce que le taux d’abandon sur la page de paiement est élevé à l’étape de saisie de l’adresse, nous pensons que réduire le formulaire de 12 à 6 champs va augmenter le taux de complétion de la commande, mesuré par le taux de conversion paiement. » Cette formulation force à répondre à trois questions avant même de lancer l’outil de test : quel problème observé justifie ce test, quel changement précis va être testé, et quelle métrique tranchera le débat.
L’origine de l’hypothèse compte aussi. Les meilleures hypothèses viennent généralement de trois sources : l’analyse quantitative (pages à fort taux de sortie, entonnoirs qui fuient à une étape précise), les retours qualitatifs (enregistrements de sessions, tests utilisateurs, réponses au support client), et la comparaison avec des pratiques déjà validées ailleurs sur des contextes similaires. Une hypothèse née d’une observation réelle a statistiquement plus de chances de produire un résultat positif qu’un changement esthétique choisi au hasard.
Étape 2 : choisir une métrique de succès unique et sans ambiguïté
Un test A/B doit être tranché par une seule métrique primaire, définie avant le lancement. C’est la métrique qui répond directement à l’hypothèse : taux de clic sur un bouton, taux de complétion d’un formulaire, taux d’ajout au panier, taux de conversion final. Suivre en parallèle des métriques secondaires (temps passé sur la page, taux de rebond, panier moyen) est utile pour comprendre le « pourquoi » du résultat, mais elles ne doivent jamais servir à déclarer un test gagnant si la métrique primaire ne bouge pas dans le sens attendu.
Ce point mérite d’être insisté : plus on suit de métriques simultanément, plus la probabilité de voir au moins l’une d’entre elles bouger « par hasard » augmente, même si le changement testé n’a aucun effet réel. C’est un phénomène statistique connu sous le nom de comparaisons multiples. Décider à l’avance quelle métrique fera foi protège contre la tentation de choisir, après coup, la métrique qui va dans le sens souhaité.
Étape 3 : estimer la taille d’échantillon nécessaire
Avant de lancer le test, il faut une estimation du nombre de visiteurs (ou de conversions) nécessaires pour obtenir un résultat fiable. Cette taille dépend principalement de trois éléments : le taux de conversion actuel de la page testée, l’ampleur de l’effet que l’on cherche à détecter (un changement qui ferait passer un taux de 2 % à 2,1 % nécessite beaucoup plus de trafic pour être détecté qu’un changement qui le ferait passer à 3 %), et le niveau de confiance statistique souhaité.
Ce sujet est suffisamment important pour mériter un traitement à part entière — c’est l’objet d’un autre article de ce blog consacré spécifiquement au calcul de taille d’échantillon. Pour ce premier test, retenez la règle pratique suivante : si votre outil de calcul indique qu’il faudra plusieurs mois pour atteindre l’échantillon requis compte tenu de votre trafic actuel, il vaut mieux tester un changement à effet plus marqué (une refonte de page plutôt qu’un changement de couleur de bouton) que de lancer un test voué à rester non concluant.
Étape 4 : répartir le trafic correctement
La répartition entre le groupe de contrôle et le groupe variante doit être aléatoire et stable : un même visiteur doit voir la même version à chaque visite pendant toute la durée du test. La plupart des outils de test A/B gèrent cette persistance automatiquement via un cookie ou un identifiant de session, mais c’est un point à vérifier avant de lancer un test, en particulier sur des sites où les visiteurs naviguent sur plusieurs appareils ou effacent régulièrement leurs cookies.
Un partage 50/50 est le plus efficace statistiquement pour atteindre la significativité le plus vite possible, mais certaines équipes préfèrent démarrer avec une répartition plus prudente (par exemple 90 % contrôle / 10 % variante) le temps de vérifier qu’aucun bug n’affecte la nouvelle version, avant de repasser à 50/50 pour la suite du test.
Étape 5 : laisser le test tourner suffisamment longtemps
Deux règles se combinent ici. La première est numérique : le test doit tourner jusqu’à ce que l’échantillon calculé à l’étape 3 soit atteint, pas moins. La seconde est temporelle : un test doit couvrir au moins un cycle complet d’une à deux semaines, pour lisser les variations de comportement entre les jours de semaine et le week-end, et idéalement couvrir plusieurs cycles de paie ou périodes commerciales si l’activité y est sensible.
L’erreur la plus fréquente chez les débutants consiste à consulter les résultats tous les jours et à arrêter le test dès qu’un écart significatif apparaît dans l’interface — parfois après seulement deux ou trois jours. Ce comportement, appelé « peeking » dans la littérature sur les tests A/B, gonfle artificiellement le taux de faux positifs : des écarts qui semblent significatifs à un instant T disparaissent souvent quelques jours plus tard, une fois l’échantillon complété. La discipline la plus simple est de fixer une durée ou un échantillon cible avant le lancement, et de s’y tenir.
Étape 6 : analyser le résultat sans le sur-interpréter
Une fois l’échantillon atteint, trois issues sont possibles : la variante fait significativement mieux que le contrôle, elle fait significativement moins bien, ou aucune différence significative n’est détectable. Ce troisième cas n’est pas un échec — c’est une information utile qui indique que le changement testé n’a pas d’effet mesurable sur le comportement des visiteurs, ce qui évite de le déployer sans bénéfice ou, à l’inverse, de continuer à investir du temps de développement dans cette direction.
Quand un résultat est significatif, il reste utile de vérifier la cohérence entre segments (mobile vs desktop, nouveaux visiteurs vs visiteurs récurrents, sources de trafic) avant de généraliser une conclusion à l’ensemble du site. Un résultat positif porté uniquement par un segment spécifique mérite une analyse plus fine avant d’être déployé partout.
Étape 7 : documenter, que le test soit gagnant, perdant ou neutre
Un test A/B qui n’est pas documenté est une opportunité d’apprentissage perdue. Consigner l’hypothèse de départ, la métrique suivie, la durée, l’échantillon atteint et le résultat obtenu permet de construire, avec le temps, une base de connaissances propre à votre audience : quels types de changements fonctionnent, lesquels n’ont pas d’effet, et pourquoi. Cette base devient plus précieuse que n’importe quel test individuel, car elle affine la qualité des hypothèses futures.
Comment prioriser ses premières idées de test
Une fois la méthode comprise, la difficulté suivante est souvent d’avoir trop d’idées de test et de ne pas savoir par laquelle commencer. Une grille de priorisation simple aide à trancher objectivement plutôt qu’à suivre la préférence de la personne la plus convaincante en réunion. Trois critères reviennent dans la plupart des grilles utilisées en CRO (Conversion Rate Optimization) :
- Le potentiel d’impact : le trafic et la valeur de la page concernée. Tester un changement sur une page vue par 1 % des visiteurs aura mécaniquement moins d’effet global qu’un test sur la page d’accueil ou le tunnel de paiement.
- La confiance dans l’hypothèse : une hypothèse née d’une donnée observée (taux d’abandon élevé, verbatims clients répétés) mérite plus de confiance qu’une intuition esthétique isolée.
- La facilité de mise en œuvre : un changement de texte ou de mise en page se teste en quelques minutes avec un éditeur visuel ; une refonte complète d’un parcours demande plus de préparation.
En notant chaque idée de test sur ces trois critères (par exemple de 1 à 5), un ordre de priorité émerge naturellement, et les premiers tests lancés sont ceux qui ont le meilleur rapport entre effort et probabilité de résultat exploitable — ce qui compte particulièrement pour un premier test, où l’objectif est aussi de prendre en main la méthode sans attendre des mois avant d’obtenir un premier résultat.
Ce qu’il faut retenir
Un test A/B fiable ne se distingue pas par la sophistication de l’outil utilisé, mais par la rigueur de la méthode : une hypothèse formulée clairement, une seule métrique de succès décidée à l’avance, un échantillon suffisant estimé avant le lancement, une durée respectée jusqu’au bout sans céder à la tentation de regarder les résultats trop tôt, et une documentation systématique du résultat, qu’il soit positif, négatif ou neutre. Ces principes s’appliquent aussi bien au premier test qu’au centième, et c’est leur application constante, plus que la taille de l’équipe ou du budget, qui distingue les programmes de test qui produisent des résultats durables de ceux qui s’essoufflent après quelques essais.
Les erreurs à connaître avant de se lancer
Ce guide se concentre sur la méthode ; un article dédié de ce blog détaille les erreurs les plus fréquentes en A/B testing, du test arrêté trop tôt au cumul de trop de variantes testées en même temps. Il complète utilement ce premier guide pour éviter les pièges classiques dès les premiers tests.
Se lancer sans complexité technique
La bonne nouvelle est que la méthode décrite ci-dessus ne nécessite aucune compétence en développement pour être appliquée. Un éditeur visuel permet de créer une variante (changer un texte, un bouton, une mise en page) directement depuis le navigateur, sans toucher au code du site, et un tableau de bord affiche l’évolution de la métrique suivie et le niveau de confiance statistique en temps réel pendant toute la durée du test.
BlastOptimize a été conçu dans cet esprit : une plateforme de test A/B et de personnalisation 100 % gratuite, pensée pour permettre à une équipe marketing de formuler une hypothèse, créer une variante et suivre un résultat sans dépendre des équipes techniques à chaque étape. Si vous avez une hypothèse en tête après avoir lu ce guide, c’est probablement le bon moment pour la tester.
Publications similaires:
- IA et CRO en 2026 : jusqu'où peut-on automatiser ses…
- CRO : définition, calcul et guide pour débuter (2026)
- Significativité statistique d'un test A/B : le guide complet
- A/B testing e-commerce : 7 idées à fort impact (2026)
- KPI A/B testing : lesquels suivre et dans quel ordre (2026)
- Faux positifs en A/B testing : les causes qu'on ne voit pas


Comments are closed.