




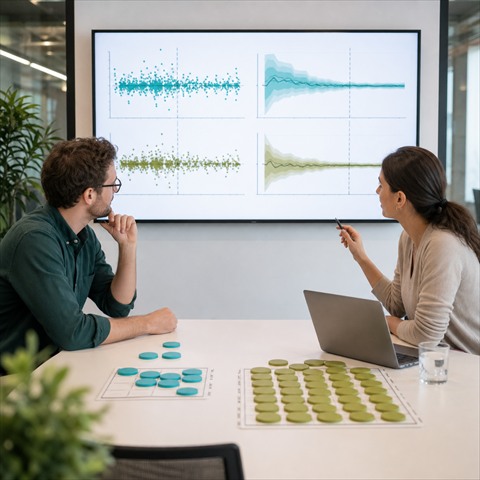
C’est l’une des questions les plus posées par les équipes qui débutent en A/B testing : combien de visiteurs, ou combien de conversions, faut-il avant de pouvoir faire confiance au résultat d’un test ? La réponse n’est pas un chiffre universel — elle dépend du taux de conversion de départ, de l’ampleur du changement que l’on cherche à détecter, et du niveau de certitude que l’on exige avant de tirer une conclusion. Cet article explique ces facteurs un par un, sans formule mathématique complexe, pour permettre d’estimer soi-même la taille d’échantillon nécessaire à un test fiable.
Pourquoi la taille d’échantillon est la question la plus importante d’un test
Un test A/B compare le comportement de deux groupes de visiteurs exposés à deux versions différentes d’une page. Mais le comportement humain varie naturellement d’un visiteur à l’autre, indépendamment de la version vue : certains jours, certaines heures, certains profils convertissent mieux que d’autres pour des raisons qui n’ont rien à voir avec le test en cours. Avec un petit échantillon, cette variation naturelle — le « bruit » statistique — peut facilement produire un écart entre les deux groupes qui ressemble à un effet réel, alors qu’il ne s’agit que d’une fluctuation aléatoire.
La taille d’échantillon est le principal levier pour distinguer un vrai signal de ce bruit. Plus l’échantillon est grand, plus les fluctuations aléatoires ont tendance à s’annuler entre elles, et plus un écart mesuré entre les deux groupes a de chances de refléter un effet réel du changement testé plutôt qu’une coïncidence. Lancer un test sans avoir estimé la taille d’échantillon nécessaire revient à décider à l’avance de ne pas savoir si le résultat obtenu est fiable.
Le taux de conversion de départ
Le premier facteur à connaître est le taux de conversion actuel de la page ou du parcours testé, sur la métrique qui servira à juger le test. Ce chiffre s’obtient simplement à partir des données déjà disponibles dans votre outil d’analyse : nombre de conversions divisé par nombre de visiteurs, sur une période récente et représentative (en excluant, si possible, une période avec une promotion exceptionnelle ou un pic de trafic atypique).
Ce taux de départ influence directement la taille d’échantillon nécessaire : à effet égal, un taux de conversion faible (par exemple 1 %) demande un échantillon plus grand qu’un taux de conversion élevé (par exemple 20 %) pour détecter le même écart relatif. C’est une des raisons pour lesquelles les tests sur des métriques rares (un achat, une souscription) demandent généralement plus de trafic et de temps que les tests sur des métriques plus fréquentes (un clic, un défilement de page).
Le MDE, ou l’ampleur de l’effet que l’on cherche à détecter
Le MDE (Minimum Detectable Effect, ou effet minimum détectable) désigne le plus petit écart entre le contrôle et la variante que le test est capable de repérer de façon fiable. C’est un choix, pas une donnée mesurée : c’est vous qui décidez quel niveau d’amélioration mérite d’être détecté.
Ce choix a un effet spectaculaire sur la taille d’échantillon nécessaire. Détecter un petit effet (par exemple faire passer un taux de conversion de 5 % à 5,2 %, soit une amélioration relative de 4 %) demande beaucoup plus de trafic que détecter un effet large (faire passer ce même taux de 5 % à 6,5 %, soit une amélioration relative de 30 %). En pratique, cela signifie qu’un changement mineur — une couleur de bouton, un mot dans un titre — nécessite un échantillon nettement plus grand qu’une refonte complète d’une page, à niveau de trafic égal, simplement parce qu’on attend de lui un effet plus modeste.
La conséquence pratique est simple : sur un site à trafic modéré, mieux vaut concentrer les premiers tests sur des changements dont on attend un effet net (restructuration d’une page, simplification d’un parcours) plutôt que sur des micro-ajustements qui demanderaient des mois pour produire un résultat exploitable.
Le niveau de confiance et la puissance statistique
Deux autres paramètres, plus techniques, complètent le calcul. Le niveau de confiance (souvent fixé à 95 %) indique la probabilité de ne pas déclarer un test gagnant à tort alors qu’il n’y a en réalité aucune différence entre les deux versions — ce qu’on appelle un faux positif. La puissance statistique (souvent fixée à 80 %) indique la probabilité de détecter un effet réel s’il existe, plutôt que de conclure à tort qu’il n’y a pas de différence — un faux négatif.
Ces deux valeurs (95 % et 80 %) sont des conventions largement utilisées dans l’industrie du test A/B, pas des règles absolues. Les augmenter (par exemple viser 99 % de confiance) réduit le risque de conclusion erronée, mais augmente encore la taille d’échantillon nécessaire ; les réduire accélère l’obtention d’un résultat, au prix d’un risque plus élevé de tirer une conclusion incorrecte. Pour un test dont les conséquences sont limitées (un ajustement facilement réversible), des seuils plus souples peuvent se justifier ; pour un test dont le résultat va conditionner une décision coûteuse à mettre en œuvre, des seuils plus stricts sont préférables.
Comment estimer sa taille d’échantillon en pratique
Dans la pratique, il est rarement nécessaire de calculer soi-même la formule statistique sous-jacente. La plupart des plateformes de test A/B, dont BlastOptimize, intègrent un calculateur qui demande simplement le taux de conversion actuel et l’effet minimum que l’on souhaite pouvoir détecter, et qui renvoie directement la taille d’échantillon nécessaire par variante, ainsi qu’une estimation de la durée du test compte tenu du trafic actuel de la page.
Cette estimation doit être faite avant de lancer le test, jamais après. Elle sert à décider si le test est réalisable dans un délai raisonnable compte tenu du trafic disponible, et si ce n’est pas le cas, à ajuster soit l’ampleur du changement testé (viser un effet plus large, donc un MDE plus élevé), soit le périmètre du test (regrouper plusieurs pages à faible trafic plutôt que tester une page isolée), soit à envisager d’autres méthodes de recherche (tests utilisateurs qualitatifs, enquêtes) quand le trafic ne permet tout simplement pas d’atteindre un échantillon suffisant dans un délai raisonnable.
L’erreur du « peeking » : regarder le résultat avant la fin
Une fois la taille d’échantillon estimée, la discipline la plus importante consiste à attendre de l’avoir atteinte avant de tirer une conclusion — même si le tableau de bord affiche un écart impressionnant après quelques jours seulement. Ce comportement, connu sous le nom de « peeking », est l’une des causes les plus fréquentes de faux résultats en A/B testing : les indicateurs de signification statistique affichés en temps réel par la plupart des outils sont calculés en continu, et un écart peut apparaître significatif à un instant donné puis se réduire, voire s’inverser, une fois l’échantillon complet atteint.
La règle pratique la plus simple pour éviter ce piège est de fixer, avant le lancement du test, à la fois une taille d’échantillon minimale et une durée minimale (généralement au moins une à deux semaines, pour couvrir les variations entre jours de semaine et week-end), et de ne considérer le résultat comme définitif que lorsque les deux conditions sont remplies simultanément.
Que faire quand le trafic est trop faible pour un test classique
Tous les sites n’ont pas le trafic nécessaire pour tester des micro-optimisations avec un échantillon confortable en quelques jours. Quand le trafic est limité, plusieurs ajustements permettent de continuer à progresser :
- Tester des changements à fort effet attendu plutôt que des micro-ajustements, pour réduire la taille d’échantillon nécessaire.
- Regrouper les métriques en suivant un objectif plus haut dans l’entonnoir (par exemple le clic vers le panier plutôt que l’achat final), quand cela reste pertinent pour l’hypothèse testée, puisque les événements plus fréquents demandent un échantillon plus petit.
- Allonger la durée du test au-delà des deux semaines habituelles, en acceptant un délai plus long avant la décision.
- Compléter les tests A/B par des méthodes qualitatives (tests utilisateurs, enregistrements de session, entretiens clients) qui n’exigent pas un grand volume de trafic pour produire des enseignements exploitables.
Un exemple concret pour visualiser le raisonnement
Pour rendre ces notions plus concrètes, prenons un exemple purement illustratif. Imaginons une page de destination dont le taux de conversion actuel est de 3 %, et une équipe qui souhaite détecter un effet minimum de 15 % en relatif (donc un passage de 3 % à environ 3,45 %), avec les seuils habituels de 95 % de confiance et 80 % de puissance statistique. Un calculateur de taille d’échantillon indiquerait, dans ce cas de figure, qu’il faut environ plusieurs milliers de visiteurs par variante pour que le test soit fiable — l’ordre de grandeur exact dépend de la formule utilisée, mais le principe reste le même : plus l’effet recherché est petit par rapport au taux de départ, plus l’échantillon nécessaire grandit rapidement.
Si la même page ne reçoit que quelques centaines de visiteurs par semaine, ce test prendrait plusieurs mois pour atteindre l’échantillon requis — un délai rarement compatible avec le rythme d’une équipe marketing. Deux options s’offrent alors : soit revoir l’hypothèse pour viser un effet plus large (un changement plus structurant plutôt qu’un ajustement mineur), soit accepter un MDE plus élevé, ce qui réduit la sensibilité du test mais aussi sa durée. Ce type d’arbitrage, fait consciemment avant le lancement, vaut mieux qu’un test lancé sans réflexion et interrompu prématurément faute de patience.
Questions fréquentes
Faut-il le même échantillon pour le contrôle et pour la variante ?
Dans la grande majorité des cas, oui : un partage égal du trafic entre les deux versions est la configuration la plus efficace pour atteindre la significativité statistique le plus rapidement possible, à trafic total égal.
Peut-on tester plus de deux variantes à la fois ?
Oui, mais chaque variante supplémentaire dilue le trafic disponible par branche et augmente d’autant la durée nécessaire pour atteindre un échantillon suffisant sur chacune. Un test A/B/C/D demande, à trafic total égal, beaucoup plus de temps qu’un test A/B classique pour obtenir une conclusion fiable sur chaque variante.
Un test peut-il être fiable avec un petit site ?
Oui, à condition d’ajuster ses attentes : privilégier des changements à fort effet potentiel, accepter des durées de test plus longues, et ne pas hésiter à compléter les tests A/B par des méthodes qui ne dépendent pas du volume de trafic, comme les tests utilisateurs qualitatifs.
Ce qu’il faut retenir
La taille d’échantillon n’est pas un détail technique réservé aux statisticiens : c’est le paramètre qui détermine si un test A/B produira une conclusion fiable ou un résultat trompeur. Elle dépend du taux de conversion de départ, de l’ampleur de l’effet que l’on cherche à détecter, et du niveau de confiance exigé — trois éléments qu’il vaut mieux estimer avant de lancer un test que découvrir, a posteriori, qu’ils invalident la conclusion. La bonne nouvelle est qu’un calculateur de taille d’échantillon intégré à l’outil de test suffit, dans l’immense majorité des cas, à faire ce calcul à la place de l’équipe marketing.
BlastOptimize intègre ce calculateur directement dans son tableau de bord, avec une estimation de la durée nécessaire compte tenu du trafic réel de la page testée, pour éviter de lancer un test voué à rester non concluant. Si vous hésitez sur la taille d’échantillon nécessaire pour votre prochain test, c’est un bon point de départ pour trancher la question avant même de créer votre variante.
Publications similaires:
- CRO : définition, calcul et guide pour débuter (2026)
- Call to action qui convertit : comment le rédiger et…
- Significativité statistique d'un test A/B : le guide complet
- Kameleoon vs solutions no-code : le CRO est-il…
- A/B testing e-commerce : 7 idées à fort impact (2026)
- Comment lancer son premier test A/B


Comments are closed.