




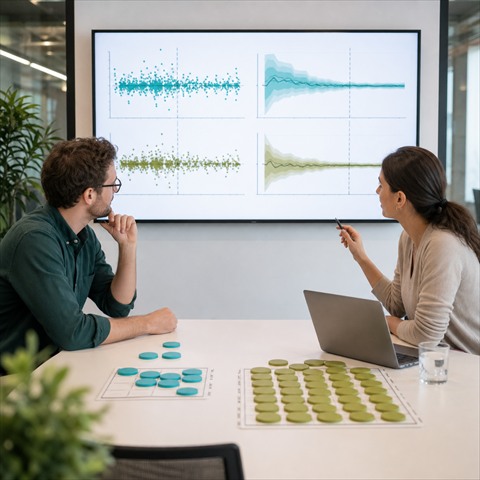
To jedno z najczęściej zadawanych pytań przez zespoły rozpoczynające przygodę z testami A/B: ilu odwiedzających, czyli ile konwersji, potrzeba, aby móc zaufać wynikom testu? Odpowiedź nie jest uniwersalna – zależy ona od początkowego współczynnika konwersji, skali zmiany, którą chcesz wykryć, oraz poziomu pewności, jakiego potrzebujesz, aby wyciągnąć wnioski. W tym artykule omówiono te czynniki po kolei, bez skomplikowanych wzorów matematycznych, dzięki czemu możesz samodzielnie oszacować wielkość próby potrzebną do przeprowadzenia wiarygodnego testu.
Dlaczego wielkość próby jest najważniejszym pytaniem w teście
Test A/B porównuje zachowanie dwóch grup użytkowników, którym przedstawiono dwie różne wersje strony. Jednak ludzkie zachowania naturalnie różnią się w zależności od użytkownika, niezależnie od wyświetlanej wersji: w niektóre dni, w niektórych przypadkach, niektóre profile konwertują lepiej niż inne z przyczyn niezwiązanych z przeprowadzanym testem. Przy małej próbie ta naturalna zmienność – statystyczny „szum” – może łatwo wywołać różnicę między dwiema grupami, która przypomina rzeczywisty efekt, podczas gdy jest jedynie losową fluktuacją.
Wielkość próby jest głównym czynnikiem odróżniającym prawdziwy sygnał od szumu. Im większa próba, tym bardziej losowe fluktuacje mają tendencję do wzajemnego znoszenia się, a tym bardziej prawdopodobne jest, że zmierzona różnica między dwiema grupami odzwierciedla rzeczywisty wpływ testowanej zmiany, a nie zbieg okoliczności. Przeprowadzenie testu bez oszacowania niezbędnej wielkości próby jest równoznaczne z wcześniejszą decyzją o wiarygodności uzyskanego wyniku.
Początkowy współczynnik konwersji
Pierwszym czynnikiem, który należy znać, jest aktualny współczynnik konwersji testowanej strony lub ścieżki użytkownika, oparty na wskaźniku, który zostanie użyty do oceny testu. Wartość tę można łatwo uzyskać z danych dostępnych w narzędziu analitycznym: liczba konwersji podzielona przez liczbę odwiedzających w niedawnym i reprezentatywnym okresie (z wyłączeniem, jeśli to możliwe, okresów z wyjątkowymi promocjami lub nietypowymi wzrostami ruchu).
Ten początkowy współczynnik bezpośrednio wpływa na wymaganą liczebność próby: aby uzyskać ten sam efekt, niski współczynnik konwersji (np. 1%) wymaga większej próby niż wysoki współczynnik konwersji (np. 20%), aby wykryć tę samą różnicę względną. To jeden z powodów, dla których testy oparte na metrykach o rzadkim działaniu (zakup, subskrypcja) zazwyczaj wymagają większego ruchu i czasu niż testy oparte na metrykach o częstszym działaniu (kliknięcie, przewijanie strony).
MDE, czyli wielkość efektu, który próbujemy wykryć
Minimalny Wykrywalny Efekt (MDE) odnosi się do najmniejszej różnicy między grupą kontrolną a wariantem, którą test może wiarygodnie wykryć. To wybór, a nie wartość mierzona: to Ty decydujesz, jaki poziom poprawy warto wykryć.
Ten wybór ma ogromny wpływ na wymaganą wielkość próby. Wykrycie niewielkiego efektu (na przykład zwiększenie współczynnika konwersji z 5% do 5,2%, co daje względną poprawę o 4%) wymaga znacznie większego ruchu niż wykrycie dużego efektu (zwiększenie tego samego współczynnika z 5% do 6,5%, co daje względną poprawę o 30%). W praktyce oznacza to, że drobna zmiana – kolor przycisku, słowo w tytule – wymaga znacznie większej próby niż całkowita przebudowa strony przy tym samym poziomie ruchu, po prostu dlatego, że oczekiwany jest mniejszy efekt.
Praktyczny skutek jest prosty: w przypadku witryny o średnim ruchu lepiej skoncentrować pierwsze testy na zmianach, po których spodziewany jest wyraźny efekt (przebudowa strony, uproszczenie ścieżki użytkownika), niż na mikrodostosowaniach, których efekty dałyby się zauważyć dopiero po miesiącach.
Poziom pewności i mocy statystycznej
Dwa inne, bardziej techniczne parametry uzupełniają obliczenia. Poziom ufności (często ustawiony na 95%) wskazuje prawdopodobieństwo błędnego uznania testu za zwycięski, gdy w rzeczywistości nie ma różnicy między obiema wersjami – co nazywa się wynikiem fałszywie dodatnim. Moc statystyczna (często ustawiona na 80%) wskazuje prawdopodobieństwo wykrycia rzeczywistego efektu, jeśli taki istnieje, zamiast błędnego wniosku o braku różnicy – wyniku fałszywie ujemnego.
Te dwie wartości (95% i 80%) to konwencje powszechnie stosowane w branży testów A/B, a nie bezwzględne reguły. Zwiększenie ich (na przykład dążenie do 99% pewności) zmniejsza ryzyko błędnego wniosku, ale dodatkowo zwiększa wymaganą liczebność próby; zmniejszenie ich przyspiesza uzyskanie wyniku, kosztem wyższego ryzyka wyciągnięcia błędnego wniosku. W przypadku testu o ograniczonych konsekwencjach (łatwo odwracalna korekta) bardziej elastyczne progi mogą być uzasadnione; w przypadku testu, którego wynik będzie determinował kosztowną decyzję, preferowane są bardziej rygorystyczne progi.
Jak w praktyce oszacować wielkość próby
W praktyce rzadko zachodzi potrzeba samodzielnego obliczania podstawowego wzoru statystycznego. Większość platform do testów A/B, w tym BlastOptimize, zawiera kalkulator, który po prostu pyta o aktualny współczynnik konwersji i minimalny efekt, jaki chcesz wykryć, i bezpośrednio zwraca wymaganą wielkość próby dla każdego wariantu, a także szacunkowy czas trwania testu na podstawie bieżącego ruchu na stronie.
Oszacowanie to należy przeprowadzić przed rozpoczęciem testu, nigdy po nim. Służy ono do ustalenia, czy test jest wykonalny w rozsądnym czasie, biorąc pod uwagę dostępny ruch, a jeśli nie, do dostosowania zakresu testowanej zmiany (dążąc do szerszego efektu, a zatem wyższego MDE), zakresu testu (grupując kilka stron o niskim ruchu zamiast testowania pojedynczej strony) lub rozważenia innych metod badawczych (jakościowe testy użytkowników, ankiety), gdy ruch po prostu nie pozwala na dotarcie do wystarczającej próby w rozsądnym czasie.
Błąd „podglądania”: patrzenie na wynik przed końcem
Po oszacowaniu liczebności próby, najważniejszym krokiem jest odczekanie do jej osiągnięcia przed wyciągnięciem wniosków – nawet jeśli panel kontrolny pokazuje imponującą rozbieżność już po kilku dniach. To zachowanie, znane jako „peeking”, jest jedną z najczęstszych przyczyn fałszywych wyników w testach A/B: wskaźniki istotności statystycznej wyświetlane w czasie rzeczywistym przez większość narzędzi są obliczane w sposób ciągły, a rozbieżność może wydawać się istotna w danym momencie, a następnie zmniejszyć się, a nawet odwrócić, gdy zostanie osiągnięta pełna liczebność próby.
Najprostszą praktyczną zasadą pozwalającą uniknąć tej pułapki jest ustalenie przed rozpoczęciem testu zarówno minimalnej liczebności próby, jak i minimalnego czasu trwania (zwykle co najmniej jednego do dwóch tygodni, aby uwzględnić różnice między dniami roboczymi a weekendami) i uznanie wyniku za ostateczny tylko wtedy, gdy oba warunki zostaną spełnione jednocześnie.
Co zrobić, gdy ruch jest zbyt mały, aby przeprowadzić standardowy test
Nie wszystkie witryny mają ruch niezbędny do testowania mikrooptymalizacji na odpowiedniej próbie przez kilka dni. Przy ograniczonym ruchu, kilka korekt może pomóc w dalszym doskonaleniu:
- Testowanie zmian o dużym oczekiwanym wpływie zamiast mikrodostosowań, w celu zmniejszenia wymaganej wielkości próby.
- Grupuj metryki poprzez realizację celu znajdującego się wyżej w leju sprzedażowym (np. kliknięcie do koszyka zamiast finalnego zakupu), gdy pozostaje on istotny w kontekście testowanej hipotezy, ponieważ częstsze zdarzenia wymagają mniejszej próby.
- Wydłuż czas trwania testu poza zwyczajowy termin dwóch tygodni, akceptując dłuższe opóźnienie w podjęciu decyzji.
- Uzupełnij testy A/B metodami jakościowymi (testy użytkowników, nagrania sesji, wywiady z klientami), które nie wymagają dużego ruchu, aby wygenerować przydatne informacje.
Konkretny przykład wizualizujący rozumowanie
Aby te koncepcje były bardziej konkretne, przyjrzyjmy się przykładowi czysto ilustracyjnemu. Wyobraźmy sobie stronę docelową z aktualnym współczynnikiem konwersji na poziomie 3% i zespół, który chce wykryć minimalny efekt względny na poziomie 15% (tj. zmianę z 3% do około 3,45%), stosując standardowe progi ufności 95% i mocy statystycznej 80%. Kalkulator wielkości próby wskazałby w tym scenariuszu, że aby test był wiarygodny, potrzeba kilku tysięcy odwiedzających na wariant – dokładny rząd wielkości zależy od użytego wzoru, ale zasada pozostaje ta sama: im mniejszy jest pożądany efekt w stosunku do współczynnika początkowego, tym szybciej rośnie wymagana wielkość próby.
Jeśli ta sama strona ma zaledwie kilkaset odwiedzających tygodniowo, test ten potrzebowałby kilku miesięcy, aby osiągnąć wymaganą liczebność próby – czas ten rzadko jest zgodny z tempem pracy zespołu marketingowego. Pojawiają się wówczas dwie opcje: albo zrewidować hipotezę, aby uzyskać szerszy efekt (bardziej strukturalna zmiana, a nie drobna korekta), albo zaakceptować wyższy MDE, co zmniejsza czułość testu, ale także skraca jego czas trwania. Ten rodzaj kompromisu, dokonany świadomie przed uruchomieniem, jest lepszy niż test uruchomiony bez dokładnego przemyślenia i przedwcześnie przerwany z powodu niecierpliwości.
Często zadawane pytania
Czy do kontroli i wariantu należy użyć tej samej próbki?
W zdecydowanej większości przypadków tak: równy podział ruchu między obiema wersjami to najbardziej efektywna konfiguracja pozwalająca jak najszybciej osiągnąć istotność statystyczną przy równym całkowitym ruchu.
Czy możemy testować więcej niż dwa warianty jednocześnie?
Tak, ale każdy dodatkowy wariant zmniejsza dostępny ruch w danym oddziale i wydłuża czas potrzebny na uzyskanie odpowiedniej liczebności próby dla każdego z nich. Test A/B/C/D, przy takim samym ruchu całkowitym, wymaga znacznie więcej czasu niż tradycyjny test A/B, aby uzyskać wiarygodne wnioski dla każdego wariantu.
Czy test może być wiarygodny w przypadku małej witryny internetowej?
Tak, pod warunkiem dostosowania oczekiwań: nadaj priorytet zmianom o potencjalnie dużym wpływie, zaakceptuj dłuższy czas trwania testów i nie wahaj się uzupełniać testów A/B metodami niezależnymi od natężenia ruchu, takimi jak jakościowe testy użytkowników.
Najważniejsze wnioski
Wielkość próby nie jest szczegółem technicznym zarezerwowanym dla statystyków; to parametr decydujący o tym, czy test A/B da wiarygodny wniosek, czy mylący. Zależy on od początkowego współczynnika konwersji, skali efektu, który próbujesz wykryć, oraz wymaganego poziomu ufności – trzech elementów, które lepiej oszacować przed rozpoczęciem testu niż odkryć po jego zakończeniu, że podważają one wniosek. Dobrą wiadomością jest to, że w zdecydowanej większości przypadków kalkulator wielkości próby zintegrowany z narzędziem testowym wystarczy, aby wykonać to obliczenie dla zespołu marketingowego.
BlastOptimize integruje ten kalkulator bezpośrednio z pulpitem nawigacyjnym, zapewniając szacunkowy czas trwania testu na podstawie rzeczywistego ruchu na testowanej stronie, co pozwala uniknąć niejednoznacznych wyników. Jeśli nie masz pewności co do wielkości próby potrzebnej do kolejnego testu, jest to dobry punkt wyjścia do podjęcia decyzji jeszcze przed utworzeniem wariantu.
Podobne publikacje:
- CRO: Definicja, obliczenia i przewodnik dla początkujących (2026)
- Call to action, które konwertuje: jak je napisać i…
- Znaczenie statystyczne testu A/B: kompletny przewodnik
- Kameleoon a rozwiązania no-code: czy CRO jest…
- Testy A/B w e-commerce: 7 pomysłów o dużym wpływie (2026)
- Jak przeprowadzić swój pierwszy test A/B



Komentarze są wyłączone.