




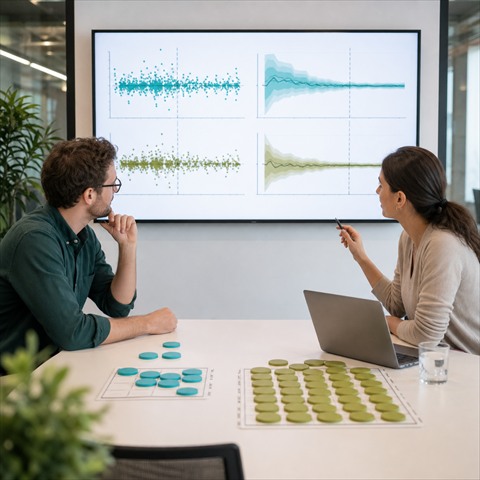
A/Bテストを始めたばかりのチームから最もよく寄せられる質問の一つに、「テスト結果を信頼できるようになるには、どれくらいの訪問者数、あるいはコンバージョン数が必要なのか?」というものがあります。答えは一律の数値ではなく、初期のコンバージョン率、検出しようとしている変化の大きさ、そして結論を出す前に求める確実性のレベルによって異なります。この記事では、複雑な数式を使わずにこれらの要素を一つずつ解説し、信頼性の高いテストに必要なサンプルサイズを自分で推定できるようにします。
なぜサンプルサイズがテストにおいて最も重要な問題なのか
A/Bテストは、2つの異なるバージョンのページを見た2つのグループの訪問者の行動を比較するものです。しかし、人間の行動は、閲覧したバージョンに関係なく、訪問者ごとに自然に異なります。日によって、時間帯によって、あるいはプロファイルによって、テストとは無関係な理由でコンバージョン率が異なる場合があるのです。サンプルサイズが小さい場合、この自然な変動(統計的な「ノイズ」)によって、単なるランダムな変動であるにもかかわらず、あたかも実際の効果があったかのように見える差が2つのグループ間に生じてしまう可能性があります。
サンプルサイズは、真の信号とノイズを区別する上で最も重要な要素です。サンプルサイズが大きいほど、ランダムな変動が互いに打ち消し合う傾向が強くなり、2つのグループ間の測定値の差が、偶然ではなく、テスト対象の変化による真の効果を反映している可能性が高くなります。必要なサンプルサイズを推定せずにテストを実施することは、得られた結果が信頼できるかどうかを事前に判断することに等しいと言えます。
開始時のコンバージョン率
まず最初に把握すべき要素は、テストの評価に使用する指標に基づいた、テスト対象のページまたはユーザー体験の現在のコンバージョン率です。この数値は、分析ツールで既に利用可能なデータから簡単に取得できます。具体的には、直近の代表的な期間(可能であれば、特別なプロモーション期間や異常なトラフィックの急増があった期間は除外)におけるコンバージョン数を訪問者数で割った値です。
この初期コンバージョン率は、必要なサンプルサイズに直接影響します。同じ効果を得るには、コンバージョン率が低い場合(例:1%)は、コンバージョン率が高い場合(例:20%)よりも、同じ相対的な差を検出するために大きなサンプルサイズが必要になります。これが、購入や購読といった頻度の低い指標に関するテストが、クリックやページスクロールといった頻度の高い指標に関するテストよりも、一般的に多くのトラフィックと時間を必要とする理由の一つです。
MDE、つまり検出しようとしている効果の大きさ
MDE(最小検出可能効果)とは、検査で確実に検出できる、対照群と変異群との間の最小の差を指します。これは測定値ではなく、選択事項です。どの程度の改善を検出する価値があるかは、あなたが決めるのです。
この選択は、必要なサンプルサイズに大きな影響を与えます。小さな効果(例えば、コンバージョン率が5%から5.2%に上昇し、相対的に4%向上する)を検出するには、大きな効果(同じコンバージョン率が5%から6.5%に上昇し、相対的に30%向上する)を検出するよりも、はるかに多くのトラフィックが必要です。実際には、同じトラフィック量であっても、ボタンの色やタイトルの単語といった些細な変更には、ページ全体の再設計よりもかなり大きなサンプルサイズが必要になります。これは、期待される効果がより小さいためです。
実際的な結論は単純明快だ。トラフィックが中程度のサイトでは、最初のテストは、明確な効果が期待できる変更(ページの再構成、ユーザー体験の簡素化など)に集中させる方が、実用的な結果が出るまでに数ヶ月かかるような細かな調整に時間を費やすよりも良い。
信頼水準と統計的検出力
計算には、さらに2つの技術的なパラメータが用いられます。信頼水準(多くの場合95%に設定)は、実際には2つのバージョンに差がないにもかかわらず、テストを誤って勝者と判断してしまう確率(偽陽性)を示します。統計的検出力(多くの場合80%に設定)は、実際に効果が存在する場合に、差がないと誤って結論付けてしまう確率(偽陰性)を示します。
これらの2つの値(95%と80%)は、A/Bテスト業界で広く用いられている慣例であり、絶対的なルールではありません。これらの値を上げる(例えば、99%の信頼度を目指す)と、誤った結論に至るリスクは減少しますが、必要なサンプルサイズはさらに大きくなります。一方、これらの値を下げると、結果を得るまでの時間は短縮されますが、誤った結論に至るリスクが高まります。影響が限定的なテスト(容易に元に戻せる調整など)の場合は、より柔軟な閾値が妥当となる場合があります。しかし、結果によってコストのかかる実装決定が左右されるテストの場合は、より厳格な閾値が望ましいでしょう。
実際にサンプルサイズを推定する方法
実際には、基礎となる統計式を自分で計算する必要はほとんどありません。BlastOptimizeをはじめとするほとんどのA/Bテストプラットフォームには、現在のコンバージョン率と検出したい最小効果を入力するだけで、バリアントごとの必要なサンプルサイズと、現在のページトラフィックに基づいたテスト期間の見積もりを直接返してくれる計算ツールが備わっています。
この見積もりは、テスト開始前に行う必要があり、開始後に行うべきではありません。これは、利用可能なトラフィックを考慮して、テストが妥当な期間内に実行可能かどうかを判断するために役立ちます。実行不可能な場合は、テスト対象の変更範囲を調整する(より広範な効果を目指し、MDEを高くする)、またはテスト範囲を調整する(単一のページをテストするのではなく、トラフィックの少ない複数のページをグループ化する)、あるいはトラフィックが妥当な期間内に十分なサンプル数を確保できない場合は、他の調査方法(定性的なユーザーテスト、アンケート)を検討する必要があります。
「結果を見る」という間違い:試合終了前に結果を見てしまうこと
サンプルサイズが推定されたら、最も重要なのは、たとえダッシュボードに数日後には大きな差異が表示されたとしても、そのサンプルサイズに達するまで結論を出さないことです。この「覗き見」と呼ばれる行為は、A/Bテストで誤った結果が生じる最も一般的な原因の一つです。ほとんどのツールでリアルタイムに表示される統計的有意性指標は継続的に計算されるため、ある時点では大きな差異に見えても、サンプルサイズが満たすと差異が減少したり、逆転したりする可能性があるのです。
この落とし穴を避けるための最も単純な実践的なルールは、テストを開始する前に、最小サンプルサイズと最小期間(平日と週末の変動を考慮するため、一般的には少なくとも1~2週間)を設定し、両方の条件が同時に満たされた場合にのみ結果を確定的なものとみなすことである。
標準テストを行うにはトラフィックが少なすぎる場合の対処法
すべてのウェブサイトが、数日間にわたって十分なサンプルサイズで微調整をテストできるほどのトラフィックを持っているわけではありません。トラフィックが限られている場合、いくつかの調整を行うことで改善を継続できます。
- 影響が大きいと予想される変更のテスト 微調整ではなく、必要なサンプルサイズを削減する。
- 指標をグループ化する ファネルの上位にある目標(例えば、最終購入ではなくカートへのクリック)を追跡することで、それが検証対象の仮説に関連している限り、より頻繁に発生するイベントはより小さなサンプルで済む。
- 試験期間を延長する 通常の2週間を超えて、決定までの遅延期間を延長することに同意する。
- 定性的な手法を用いてA/Bテストを補完する (ユーザーテスト、セッション記録、顧客インタビューなど)は、実用的な洞察を得るために大量のトラフィックを必要としません。
論理を視覚化するための具体的な例
これらの概念をより具体的に理解するために、純粋に説明的な例を挙げてみましょう。現在のコンバージョン率が3%のランディングページがあり、チームが95%の信頼度と80%の統計的検出力という通常の閾値を使用して、少なくとも15%の相対効果(つまり、3%から約3.45%への変化)を検出したいと考えているとします。サンプルサイズ計算機を使用すると、このシナリオでは、テストが信頼できるものとなるためには、バリエーションごとに数千人の訪問者が必要であることがわかります。正確な桁数は使用する計算式によって異なりますが、原理は同じです。初期率に対する望ましい効果が小さいほど、必要なサンプルサイズは急速に増加します。
同じページへの訪問者数が週に数百人程度の場合、このテストでは必要なサンプルサイズに達するまでに数か月かかることになり、マーケティングチームのペースとは相容れない期間となります。そこで、2つの選択肢が考えられます。1つは、より広範な効果(軽微な調整ではなく、より構造的な変化)を目標とするように仮説を修正すること、もう1つは、MDE(最小検出可能効果)を高く設定することです。MDEを高く設定すると、テストの感度は低下しますが、テスト期間も長くなります。このようなトレードオフは、開始前に意識的に行う方が、慎重な検討なしに開始し、焦りから途中で中断してしまうテストよりも優れています。
よくある質問
対照群と変異群には同じサンプルを使用すべきでしょうか?
ほとんどの場合、答えはイエスです。2つのバージョン間でトラフィックを均等に分配することが、総トラフィックを均等にしながら、統計的有意性をできるだけ早く達成するための最も効率的な構成です。
一度に2つ以上の変異株をテストすることはできますか?
はい、しかしバリアントを追加するごとに、各ブランチで利用可能なトラフィックが分散され、各バリアントで十分なサンプルサイズを取得するのに必要な時間が増加します。総トラフィックが同じA/B/C/Dテストでは、各バリアントについて信頼できる結論に達するまでに、従来のA/Bテストよりもはるかに多くの時間を要します。
小規模なウェブサイトでも、テストの信頼性は確保できるのか?
はい、ただし期待値を調整する必要があります。つまり、大きな影響を与える可能性のある変更を優先し、テスト期間が長くなることを許容し、トラフィック量に依存しない方法(例えば、定性的なユーザーテストなど)でA/Bテストを補完することをためらわないでください。
主なポイント
サンプルサイズは統計学者だけが扱う技術的な詳細ではなく、A/Bテストが信頼できる結論を生み出すか、誤解を招く結果を生み出すかを決定するパラメータです。サンプルサイズは、初期コンバージョン率、検出しようとしている効果の大きさ、および必要な信頼水準によって決まります。これら3つの要素は、テスト開始後に結論が無効になることが判明するよりも、テスト開始前に見積もっておく方がはるかに良いでしょう。幸いなことに、ほとんどの場合、テストツールに組み込まれたサンプルサイズ計算ツールを使えば、マーケティングチームがこの計算を行うことができます。
BlastOptimizeはこの計算ツールをダッシュボードに直接統合しており、テスト対象ページへの実際のトラフィックに基づいて必要なテスト期間を推定することで、結果が不明確なテストの実行を防ぎます。次のテストに必要なサンプルサイズがわからない場合は、バリアントを作成する前に、このツールを使ってサンプルサイズを決定するのが良いでしょう。


コメントは締め切りました。