




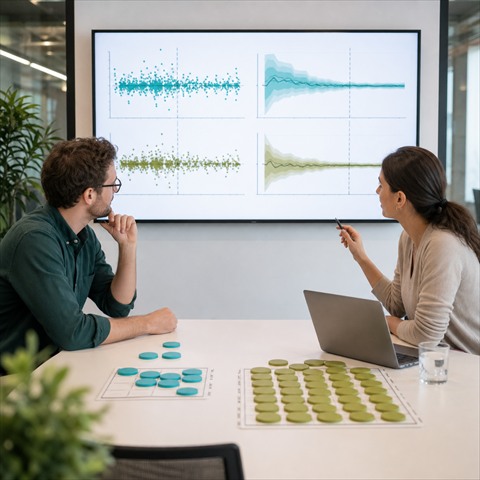
Eine der häufigsten Fragen von Teams, die neu im Bereich A/B-Testing sind, lautet: Wie viele Besucher oder Conversions benötigt man, um den Testergebnissen vertrauen zu können? Die Antwort ist nicht pauschal – sie hängt von Ihrer anfänglichen Conversion-Rate, dem Ausmaß der zu messenden Veränderung und dem gewünschten Grad an Sicherheit ab, bevor Sie eine Schlussfolgerung ziehen. Dieser Artikel erklärt diese Faktoren einzeln und ohne komplexe mathematische Formeln, sodass Sie die für einen zuverlässigen Test benötigte Stichprobengröße selbst abschätzen können.
Warum die Stichprobengröße die wichtigste Frage bei einem Test ist
Ein A/B-Test vergleicht das Verhalten zweier Besuchergruppen, denen zwei verschiedene Versionen einer Seite angezeigt werden. Das menschliche Verhalten variiert jedoch naturgemäß von Besucher zu Besucher, unabhängig von der angezeigten Version: An manchen Tagen und zu bestimmten Zeiten erzielen manche Profile bessere Konversionsraten als andere, aus Gründen, die nichts mit dem durchgeführten Test zu tun haben. Bei einer kleinen Stichprobe kann diese natürliche Variation – statistisches „Rauschen“ – leicht einen Unterschied zwischen den beiden Gruppen erzeugen, der einem realen Effekt ähnelt, obwohl es sich lediglich um eine zufällige Schwankung handelt.
Die Stichprobengröße ist der entscheidende Faktor, um ein echtes Signal von Rauschen zu unterscheiden. Je größer die Stichprobe, desto mehr heben sich zufällige Schwankungen gegenseitig auf, und desto wahrscheinlicher spiegelt ein gemessener Unterschied zwischen zwei Gruppen einen tatsächlichen Effekt der untersuchten Veränderung wider und ist kein Zufall. Einen Test durchzuführen, ohne die notwendige Stichprobengröße vorher zu bestimmen, bedeutet, im Voraus zu entscheiden, ob das Ergebnis zuverlässig ist.
Der anfängliche Umrechnungskurs
Der erste wichtige Faktor ist die aktuelle Conversion-Rate der getesteten Seite oder des getesteten Nutzerpfads, basierend auf der Kennzahl, die zur Auswertung des Tests verwendet wird. Diese Kennzahl lässt sich leicht aus den bereits in Ihrem Analysetool verfügbaren Daten ermitteln: Anzahl der Conversions geteilt durch Anzahl der Besucher über einen aktuellen und repräsentativen Zeitraum (wenn möglich ohne Zeiträume mit Sonderaktionen oder ungewöhnlich hohen Besucherzahlen).
Diese Ausgangsrate beeinflusst direkt die erforderliche Stichprobengröße: Um denselben Effekt zu erzielen, benötigt man bei einer niedrigen Konversionsrate (z. B. 1 %) eine größere Stichprobe als bei einer hohen Konversionsrate (z. B. 20 %), um denselben relativen Unterschied festzustellen. Dies ist ein Grund dafür, dass Tests mit seltenen Metriken (Kauf, Abonnement) in der Regel mehr Traffic und Zeit benötigen als Tests mit häufigeren Metriken (Klick, Scrollen auf der Seite).
Der MDE, also die Stärke des Effekts, den wir zu erfassen versuchen.
Der MDE (Minimaler Nachweisbarer Effekt) bezeichnet den kleinsten Unterschied zwischen der Kontrollgruppe und der Variante, den der Test zuverlässig nachweisen kann. Es handelt sich um eine Wahlmöglichkeit, nicht um einen Messwert: Sie entscheiden, welche Verbesserung als relevant für die Erkennung angesehen wird.
Diese Wahl hat einen erheblichen Einfluss auf die erforderliche Stichprobengröße. Um einen kleinen Effekt nachzuweisen (z. B. eine Steigerung der Conversion-Rate von 5 % auf 5,2 %, eine relative Verbesserung von 4 %), ist deutlich mehr Traffic erforderlich als um einen großen Effekt nachzuweisen (z. B. eine Steigerung derselben Rate von 5 % auf 6,5 %, eine relative Verbesserung von 30 %). In der Praxis bedeutet dies, dass eine geringfügige Änderung – etwa die Farbe eines Buttons oder ein Wort im Titel – bei gleichem Traffic eine wesentlich größere Stichprobe erfordert als eine komplette Seitenüberarbeitung, einfach weil ein geringerer Effekt erwartet wird.
Die praktische Konsequenz ist einfach: Auf einer Website mit mäßigem Traffic ist es besser, sich bei den ersten Tests auf Änderungen zu konzentrieren, von denen ein klarer Effekt zu erwarten ist (Umstrukturierung einer Seite, Vereinfachung eines Nutzerflusses), anstatt auf Mikroanpassungen, deren Erzielung eines brauchbaren Ergebnisses Monate dauern würde.
Das Konfidenzniveau und die statistische Aussagekraft
Zwei weitere, eher technische Parameter vervollständigen die Berechnung. Das Konfidenzniveau (oft auf 95 % festgelegt) gibt die Wahrscheinlichkeit an, einen Test fälschlicherweise als Gewinner zu erklären, obwohl tatsächlich kein Unterschied zwischen den beiden Versionen besteht – ein sogenanntes falsch positives Ergebnis. Die statistische Power (oft auf 80 % festgelegt) gibt die Wahrscheinlichkeit an, einen tatsächlichen Effekt zu erkennen, falls ein solcher existiert, anstatt fälschlicherweise zu schlussfolgern, dass kein Unterschied besteht – ein falsch negatives Ergebnis.
Diese beiden Werte (95 % und 80 %) sind in der A/B-Testing-Branche weit verbreitete Konventionen und keine absoluten Regeln. Eine Erhöhung (z. B. auf 99 % Konfidenz) verringert das Risiko einer Fehlinterpretation, erhöht aber den erforderlichen Stichprobenumfang. Eine Senkung beschleunigt die Ergebniserzielung, birgt jedoch ein höheres Risiko für eine Fehlinterpretation. Bei einem Test mit begrenzten Konsequenzen (einer leicht reversiblen Anpassung) können flexiblere Schwellenwerte gerechtfertigt sein; bei einem Test, dessen Ergebnis eine kostspielige Implementierungsentscheidung bestimmt, sind strengere Schwellenwerte vorzuziehen.
Wie man in der Praxis die Stichprobengröße schätzt
In der Praxis ist es selten nötig, die zugrundeliegende statistische Formel selbst zu berechnen. Die meisten A/B-Testing-Plattformen, darunter auch BlastOptimize, bieten einen Rechner, der lediglich die aktuelle Conversion-Rate und den minimalen Effekt, den Sie nachweisen möchten, abfragt und direkt die erforderliche Stichprobengröße pro Variante sowie eine Schätzung der Testdauer basierend auf dem aktuellen Seitenaufruf liefert.
Diese Einschätzung muss vor dem Teststart erfolgen, niemals danach. Sie dient dazu, zu entscheiden, ob der Test angesichts des verfügbaren Datenverkehrs innerhalb eines angemessenen Zeitraums durchführbar ist. Falls nicht, muss entweder der Umfang der zu testenden Änderung angepasst werden (um eine breitere Wirkung und damit einen höheren MDE-Wert zu erzielen), oder der Testumfang erweitert werden (indem mehrere Seiten mit geringem Traffic zusammengefasst werden, anstatt eine einzelne Seite zu testen). Alternativ können andere Forschungsmethoden (qualitative Nutzertests, Umfragen) in Betracht gezogen werden, wenn der Datenverkehr es schlichtweg nicht zulässt, innerhalb eines angemessenen Zeitraums eine ausreichende Stichprobe zu erreichen.
Der „Spähfehler“: das Ergebnis vor dem Ende ansehen.
Sobald die Stichprobengröße geschätzt ist, ist es entscheidend, mit Schlussfolgerungen zu warten, bis diese erreicht ist – selbst wenn das Dashboard bereits nach wenigen Tagen eine beeindruckende Abweichung anzeigt. Dieses Verhalten, bekannt als „Spicken“, ist eine der häufigsten Ursachen für falsche Ergebnisse bei A/B-Tests: Die von den meisten Tools in Echtzeit angezeigten Indikatoren für statistische Signifikanz werden kontinuierlich berechnet, und eine Abweichung kann zu einem bestimmten Zeitpunkt signifikant erscheinen und dann abnehmen oder sich sogar umkehren, sobald die volle Stichprobengröße erreicht ist.
Die einfachste praktische Regel, um diese Falle zu vermeiden, ist, vor Beginn des Tests sowohl eine Mindeststichprobengröße als auch eine Mindestdauer festzulegen (in der Regel mindestens ein bis zwei Wochen, um die Unterschiede zwischen Wochentagen und Wochenenden abzudecken) und das Ergebnis erst dann als endgültig zu betrachten, wenn beide Bedingungen gleichzeitig erfüllt sind.
Was tun, wenn der Verkehr für einen Standardtest zu gering ist?
Nicht alle Websites verfügen über genügend Traffic, um Mikrooptimierungen mit einer aussagekräftigen Stichprobengröße über mehrere Tage hinweg zu testen. Bei begrenztem Traffic können verschiedene Anpassungen zur weiteren Verbesserung beitragen:
- Testen von Änderungen mit einer hohen erwarteten Auswirkung statt Mikroanpassungen, um die erforderliche Stichprobengröße zu reduzieren.
- Gruppieren Sie die Kennzahlen indem man ein Ziel weiter oben im Verkaufstrichter verfolgt (z. B. Klick zum Warenkorb anstatt zum endgültigen Kauf), wenn es für die zu testende Hypothese noch relevant ist, da häufigere Ereignisse eine kleinere Stichprobe erfordern.
- Verlängern Sie die Testdauer. über die üblichen zwei Wochen hinaus, indem eine längere Verzögerung vor der Entscheidung akzeptiert wird.
- Ergänzen Sie A/B-Tests durch qualitative Methoden. (Nutzertests, Sitzungsaufzeichnungen, Kundeninterviews), die kein großes Datenverkehrsaufkommen erfordern, um verwertbare Erkenntnisse zu gewinnen.
Ein konkretes Beispiel zur Veranschaulichung der Argumentation
Um diese Konzepte zu veranschaulichen, betrachten wir ein einfaches Beispiel. Stellen Sie sich eine Landingpage mit einer aktuellen Conversion-Rate von 3 % vor und ein Team, das einen minimalen relativen Effekt von 15 % (d. h. eine Steigerung von 3 % auf ca. 3,45 %) nachweisen möchte. Dabei werden die üblichen Schwellenwerte von 95 % Konfidenzintervall und 80 % Teststärke verwendet. Ein Stichprobenrechner würde in diesem Szenario ergeben, dass mehrere Tausend Besucher pro Variante benötigt werden, um einen zuverlässigen Test zu gewährleisten. Die genaue Größenordnung hängt von der verwendeten Formel ab, das Prinzip bleibt jedoch gleich: Je kleiner der gewünschte Effekt im Verhältnis zur Ausgangsrate ist, desto schneller steigt der erforderliche Stichprobenumfang.
Wenn dieselbe Seite nur wenige hundert Besucher pro Woche verzeichnet, würde dieser Test mehrere Monate dauern, bis die erforderliche Stichprobengröße erreicht ist – ein Zeitraum, der selten mit dem Tempo eines Marketingteams vereinbar ist. Es bieten sich zwei Optionen an: Entweder die Hypothese wird überarbeitet, um einen umfassenderen Effekt anzustreben (eine eher strukturelle Veränderung als eine geringfügige Anpassung), oder ein höherer minimaler Effekt (MDE) wird akzeptiert, was zwar die Sensitivität des Tests verringert, aber auch seine Dauer. Diese Art von Abwägung, die bewusst vor dem Start getroffen wird, ist besser als ein Test, der ohne sorgfältige Überlegung gestartet und aufgrund von Ungeduld vorzeitig abgebrochen wird.
Häufig gestellte Fragen
Soll für die Kontrollprobe und die Variante dieselbe Probe verwendet werden?
In den allermeisten Fällen ja: Eine gleichmäßige Aufteilung des Datenverkehrs zwischen den beiden Versionen ist die effizienteste Konfiguration, um bei gleichem Gesamtdatenverkehr so schnell wie möglich statistische Signifikanz zu erreichen.
Können wir mehr als zwei Varianten gleichzeitig testen?
Ja, aber jede zusätzliche Variante verringert den verfügbaren Traffic pro Zweig und verlängert die Zeit, die benötigt wird, um für jede Variante eine ausreichende Stichprobengröße zu erhalten. Ein A/B/C/D-Test benötigt bei gleichem Gesamt-Traffic deutlich mehr Zeit als ein herkömmlicher A/B-Test, um zu einer verlässlichen Schlussfolgerung für jede Variante zu gelangen.
Kann ein Test bei einer kleinen Website zuverlässig sein?
Ja, vorausgesetzt, die Erwartungen werden angepasst: Änderungen mit hohem Wirkungspotenzial sollten priorisiert, längere Testdauern akzeptiert und A/B-Tests sollten nicht durch Methoden ergänzt werden, die nicht vom Trafficvolumen abhängen, wie z. B. qualitative Nutzertests.
Wichtigste Erkenntnisse
Die Stichprobengröße ist keine rein technische Angelegenheit für Statistiker; sie ist der Parameter, der darüber entscheidet, ob ein A/B-Test zu einer verlässlichen oder irreführenden Schlussfolgerung führt. Sie hängt von der anfänglichen Konversionsrate, der Stärke des zu messenden Effekts und dem erforderlichen Konfidenzniveau ab – drei Faktoren, die sich besser vor dem Teststart abschätzen lassen, als im Nachhinein festzustellen, dass sie die Schlussfolgerung entkräften. Die gute Nachricht: Ein in das Testtool integrierter Stichprobenrechner ist in den allermeisten Fällen ausreichend, um diese Berechnung für das Marketingteam durchzuführen.
BlastOptimize integriert diesen Rechner direkt in sein Dashboard und liefert eine Schätzung der benötigten Testdauer basierend auf dem tatsächlichen Traffic der getesteten Seite. So wird vermieden, dass ein Test ergebnislos verläuft. Wenn Sie sich bezüglich der benötigten Stichprobengröße für Ihren nächsten Test unsicher sind, ist dies ein guter Ausgangspunkt, um dies bereits vor der Erstellung Ihrer Testvariante festzulegen.
Ähnliche Veröffentlichungen:
- CRO: Definition, Berechnung und ein Leitfaden für Anfänger (2026)
- Call to Action, der konvertiert: wie man ihn formuliert und…
- Statistische Signifikanz eines A/B-Tests: Der vollständige Leitfaden
- Kameleoon vs. No-Code-Lösungen: Ist CRO…
- A/B-Testing im E-Commerce: 7 wirkungsvolle Ideen (2026)
- So führen Sie Ihren ersten A/B-Test durch


Die Kommentarfunktion ist deaktiviert.